Reflexão
por
Carolina de Oliveira
Status de leitura
Faça login para usar este recurso
©2026 MIT Sloan Management Review Brasil. Todos os direitos reservados. A reprodução, total ou parcial, é proibida sem a autorização prévia e expressa do CNEX.
Um modelo para ciências da vida explicita uma virada que vinha acontecendo em silêncio: o valor da IA migrou do tamanho para o domínio.
Foi uma quinta-feira, 17 de abril. Eu estava entre duas reuniões quando a notícia apareceu: a OpenAI havia lançado o GPT-Rosalind, um modelo verticalizado para a indústria de ciências da vida, posicionado para descoberta de fármacos, pesquisa biomédica e workflows científicos.
Minha reação imediata foi curiosidade. Depois, aquele reflexo automático de decodificar o movimento, entender a jogada por trás do anúncio e perguntar onde isso se encaixa no tabuleiro maior.
E aqui a coisa começa a ficar interessante. Porque o Rosalind conversa diretamente com outro movimento recente que explorei nesta publicação, o dos agentes autônomos e do Claude Cowork. Um complementa o outro. Juntos, apontam para uma mudança de fase no mercado de IA que merece olhar com cuidado.
Rosalind, ao pé da letra, é um modelo orientado a ciências da vida, com foco em descoberta de fármacos, análise de literatura biomédica e integração com workflows científicos. Nada de revolucionário na descrição técnica isolada. Já existem Med-PaLM 2 na medicina, BloombergGPT em finanças, Harvey no direito, e uma série de iniciativas menos visíveis em cibersegurança, agronegócio e manufatura.
O que importa é o gesto estratégico por trás. Quando um fornecedor de frontier model como a OpenAI decide empacotar sua capacidade geral em uma oferta setorial, ela está sinalizando algo que nem sempre aparece na capa dos releases. O próximo ciclo competitivo da IA será decidido na camada do domínio, e não mais na do modelo bruto. Quem entender isso antes vai redesenhar sua agenda de tecnologia enquanto os concorrentes ainda debatem qual licença renovar.
Rosalind não inaugura a verticalização. Ele a explicita.
E o problema de uma tendência que se explicita tarde é que a maioria das organizações ainda está operando como se a pergunta fosse outra.
Nos últimos três anos, a pergunta que dominou as conversas executivas sobre IA foi quase sempre a mesma: qual modelo usar? ChatGPT ou Claude? Gemini ou Llama? Open-source ou proprietário? Maior contexto ou maior raciocínio?
É uma pergunta legítima, mas que envelheceu rápido. E pior, envelheceu sem que muita gente percebesse.
Porque enquanto as áreas de tecnologia debatiam benchmarks, a economia real da IA já estava migrando de lugar. O valor deixou de estar concentrado na capacidade genérica do modelo e começou a se acumular em três camadas adjacentes: nos dados proprietários que alimentam o sistema, nas ferramentas que conectam o modelo ao workflow real, e na governança que permite operar com risco controlado em contextos regulados.
Qual é a implicação prática disso? Que uma organização pode ter acesso ao melhor modelo do mundo e, ainda assim, extrair pouco valor, enquanto uma empresa com dado proprietário bem curado e workflow bem desenhado pode construir vantagem competitiva real usando um modelo aberto, mais barato e menor.
Se essa inversão não está clara no seu comitê de tecnologia, é porque ele ainda está discutindo a pergunta errada.
Para entender por que chegamos aqui, vale recuperar a história dos últimos sete anos em linguagem de negócio, não técnica. Uso uma metáfora de perfis profissionais porque ela deixa a curva mais nítida.
BERT, em 2018, foi o analista de leitura. Entendia contexto, relações entre palavras, significado local. Era excelente para busca, classificação, perguntas e respostas baseadas em documentos. Virou infraestrutura silenciosa de buscadores e sistemas de texto.
GPT-3, em 2020, foi o generalista versátil. Não apenas lia, produzia. Redigia, resumia, continuava raciocínios, seguia instruções. A escala de dados e parâmetros virou alavanca econômica quase industrial, com ganhos previsíveis de desempenho conforme se investia mais capital computacional.
GPT-4, em 2023, foi o generalista sênior. Melhor alinhamento, mais robustez, multimodalidade. A IA deixou de apenas escrever e passou a trabalhar em muitas tarefas com qualidade equivalente à de um profissional mediano em várias delas.
Rosalind, em 2026, é o especialista setorial. Não compete com GPT-4 em amplitude. Compete em profundidade específica, vocabulário técnico, familiaridade com workflows científicos, integração com bases proprietárias e regras de segurança adequadas ao contexto.
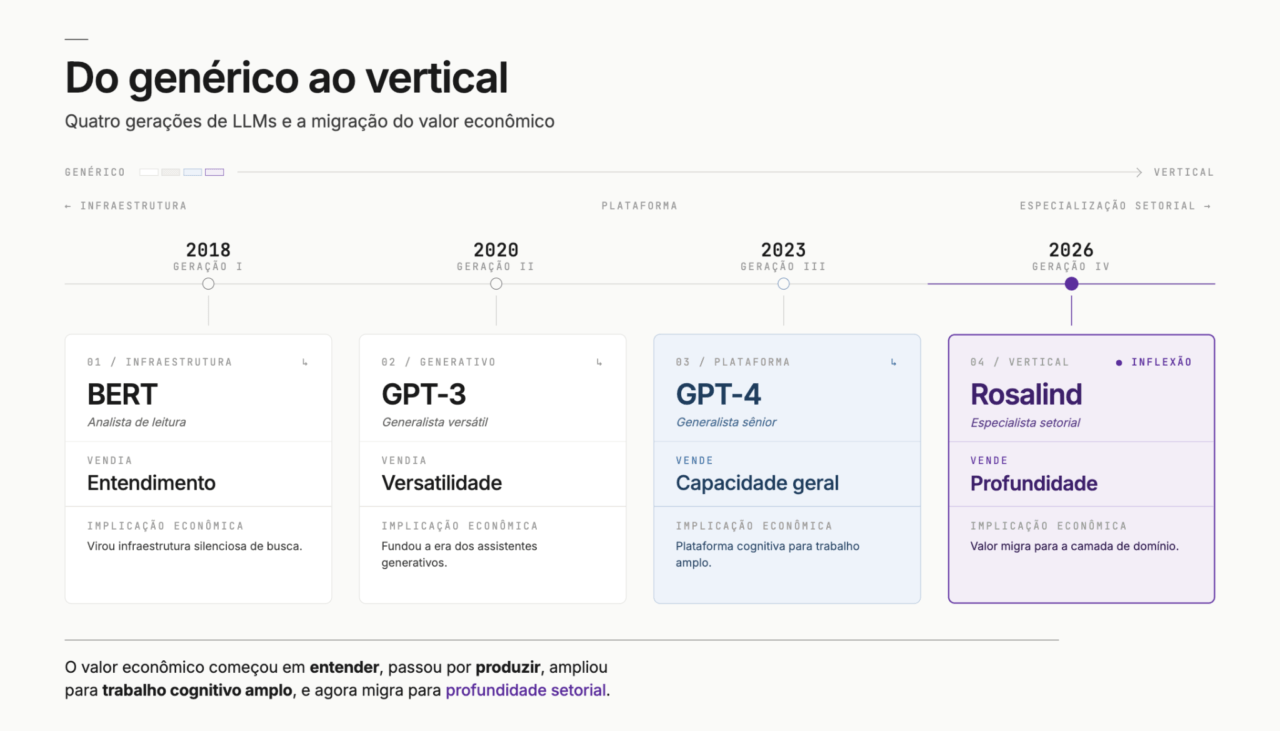
A progressão parece natural quando olhamos para trás. Mas cada salto mudou a unidade econômica do valor. BERT vendia entendimento. GPT-3 vendia versatilidade. GPT-4 vendeu capacidade geral de trabalho cognitivo. Rosalind e seus pares vendem desempenho confiável em contexto específico.
Quando a plataforma generalista amadurece, o próximo passo natural é que camadas mais especializadas capturem o valor adjacente. É o que a economia industrial fez com a eletricidade, com a internet, com a nuvem. Não há razão para esperar que a IA seja diferente.
Se a tendência é tão clara em retrospecto, por que ela passou relativamente despercebida pela maioria dos executivos?
Porque os sinais vieram fragmentados, em setores específicos, sem uma narrativa unificadora. Vale recapitular quatro deles.
Finanças. O BloombergGPT, lançado em 2023, foi treinado com 50 bilhões de parâmetros em um corpus que combinou 363 bilhões de tokens financeiros com 345 bilhões de tokens gerais. O resultado foi superior em tarefas de finanças sem perda relevante de capacidade geral. A Bloomberg provou algo importante: quando você tem dado proprietário abundante e problema específico repetitivo, treinar ou ajustar um modelo vertical compensa.
Medicina. O Med-PaLM 2, do Google, estabeleceu referência em benchmarks médicos e virou marco de pesquisa em IA clínica. O aprendizado aqui foi diferente. Não bastava ter bom desempenho em teste. Segurança clínica, fundamentação em fontes, revisão humana e critérios de uso passaram a ser parte integrante do sistema. Saúde ensinou que um LLM vertical é uma arquitetura de produção mais cuidadosa, não apenas um modelo melhor.
Direito. Harvey se consolidou como plataforma de IA jurídica em grandes firmas, e o BigLaw Bench surgiu para medir tarefas próximas ao trabalho real de advogados. A lição foi que verticalização também é medir melhor. Benchmark genérico não diz nada sobre utilidade real em contexto profissional de alto risco.
Cibersegurança. A OpenAI começou a falar em trusted access, uso controlado de modelos para defesa cibernética, reconhecendo o caráter dual-use do domínio. Aqui o recado foi ainda mais específico. Algumas verticais passam a ser restritas, auditadas e cercadas por controles de acesso.
Quando olho para esses quatro sinais em conjunto, a conclusão que emerge é inescapável. A verticalização vinha se acumulando há pelo menos três anos. Rosalind é só o momento em que a OpenAI, o fornecedor mais visível e simbólico do mercado, chancelou a direção.
Sua organização precisa que a OpenAI chancele para começar a se mover?
Aqui está a parte que mais me provoca nessa história, e que ainda não vi sendo discutida com profundidade.
Na era dos modelos genéricos, havia uma espécie de democratização embutida. Qualquer empresa com cartão de crédito podia acessar a mesma capacidade de IA. O diferencial estava no uso, mas o insumo era universalmente disponível.
Na era dos modelos verticais, a lógica se inverte. Modelos especializados extraem mais valor quando conectados a dados proprietários bem curados, workflows bem mapeados e regras de negócio bem documentadas. Sem esses três elementos, um LLM vertical rende menos que um generalista bem orquestrado.
O paradoxo é que a tecnologia se democratiza em acesso, mas a vantagem competitiva se concentra em quem tem dado. Organizações que durante anos trataram dado como subproduto operacional de baixo custo agora descobrem que estão sentadas sobre o novo diferencial estratégico. Ou, pior, descobrem que o dado que imaginavam ter está fragmentado, mal documentado, trancado em sistemas legados e cercado por débitos técnicos que demandariam anos para limpar.
Esse é o custo invisível que a era da verticalização está cobrando. Empresas que investiram sério em arquitetura de dados nos últimos cinco anos entram na nova fase com vantagem estrutural. Empresas que adiaram, ou que terceirizaram o problema como se fosse apenas questão de TI, descobrem agora que precisam correr duas corridas ao mesmo tempo.
E aqui vai uma observação que colho de conversas recentes com líderes executivos brasileiros: a segunda corrida, a do dado, costuma ser mais dolorosa que a primeira. Porque ela mexe com processo, com cultura, com silos estabelecidos, com políticas de acesso que ninguém quer abrir. Comprar IA é fácil. Arrumar a casa do dado é o trabalho duro que ninguém quis fazer antes, e agora virou pré-requisito.
Durante anos, o comitê de tecnologia das empresas discutiu qual IA contratar. Negociou licenças de ChatGPT Enterprise, implantou Copilot para times, testou Claude para áreas específicas. Essas decisões foram relevantes, e ainda são. Mas são cada vez mais insuficientes.
A pergunta que melhor captura o momento atual é outra. Qual arranjo entre modelo, dados, ferramentas, processos e governança produz o melhor resultado para este problema específico? Essa pergunta muda quem precisa estar na mesa. Muda o tipo de investimento que faz sentido. Muda a forma de medir retorno. E muda, sobretudo, o perfil de quem lidera a agenda de IA dentro da empresa.
Quem ainda trata a IA como ilusão de controle linear, com ROI previsível e caminho único de implantação, vai descobrir que a verticalização amplifica a natureza probabilística da tecnologia. Profundidade setorial significa contexto, significa risco específico, significa erro com consequência. Os agentes e modelos que realmente entregam valor nessa nova camada não são os generalistas polidos. São os que conhecem o domínio com profundidade suficiente para agir com discernimento dentro dele.
Preciso falar do contexto onde a maioria dos leitores desta publicação opera.
Há uma narrativa fácil sobre o Brasil na era da IA que diz, mais ou menos, o seguinte: não temos capital, infraestrutura ou ecossistema de pesquisa para competir com Estados Unidos e China no desenvolvimento de frontier models, então nos resta o papel de consumidores. Essa narrativa é preguiçosa, e está ficando datada.
Nos últimos dois anos, o Brasil se posicionou como destino relevante de investimento em infraestrutura de IA. A AWS comprometeu R$ 10,1 bilhões em expansão de data centers até 2034. A Microsoft anunciou R$ 14,7 bilhões em três anos para infraestrutura de nuvem e IA, o maior aporte único da companhia no país. E o Plano Brasileiro de Inteligência Artificial, lançado em julho de 2024, prevê R$ 23 bilhões em investimentos até 2028, com foco em cinco eixos que incluem infraestrutura própria, desenvolvimento de modelos em português brasileiro e aplicação setorial em saúde, segurança, indústria e serviços públicos.
O cenário é menos unidimensional do que a narrativa consumidora sugere. O Brasil está se consolidando como um dos polos tecnológicos regionais, com volume de capital e capacidade instalada que permite ambição maior do que apenas importar tecnologia pronta.
E aqui mora o ponto que muitos executivos ainda não conectaram. O próprio PBIA, no coração de seus objetivos, inclui o desenvolvimento de modelos de linguagem treinados em dados nacionais, com características culturais, sociais e linguísticas brasileiras. Isso é, em essência, verticalização por língua e contexto. O Brasil está apostando, com dinheiro público, na mesma tese que a OpenAI acaba de chancelar com o Rosalind.
Porque temos algo que poucos países reúnem com a mesma densidade. Um dos maiores sistemas de saúde pública do mundo, com volume de dado clínico raro. Um setor financeiro sofisticado, bancarizado e digitalizado, com décadas de histórico transacional. Um dos maiores agronegócios do planeta, com dado de safra, clima e solo acumulado. Um Judiciário volumoso, com jurisprudência extensa e processo eletrônico consolidado.
A janela brasileira não está em escolher entre importar ou construir. Está em combinar as duas coisas com inteligência estratégica. Usar a infraestrutura que as big techs estão instalando aqui. Aproveitar os incentivos públicos disponíveis. E, sobretudo, construir camadas verticais nos setores onde temos densidade de dado e problema real. Saúde pública, crédito, agro, serviços jurídicos, serviços públicos.
Empresas, instituições e consórcios que conseguirem organizar, curar e proteger esses dados poderão construir verticais brasileiras relevantes, possivelmente competitivas em escala global em nichos específicos. O risco, se não fizermos isso com velocidade e coordenação, é ver nossos dados alimentando modelos de terceiros que depois voltam para cá vendidos como serviço premium.
Quem aqui dentro está olhando para isso com prioridade estratégica, e não como projeto de inovação?
Há três direções que parecem incontornáveis para quem está à frente de uma agenda corporativa de IA nos próximos meses.
A primeira é auditar onde sua organização ainda usa IA genérica em contextos que já pedem profundidade. Atendimento ao cliente em setor regulado, análise de contratos, avaliação de risco de crédito, suporte clínico, compliance. Em cada um desses espaços, continuar usando modelo genérico quando verticais começam a existir significa escolher, talvez sem perceber, ficar para trás.
A segunda é tratar dado proprietário como ativo estratégico, não como custo de TI. Isso implica orçamento, governança, liderança executiva dedicada e plano plurianual. Em muitas empresas, o CDO ainda responde três níveis abaixo do CEO. Na era da verticalização, isso é miopia estrutural.
A terceira é começar a mapear fornecedores verticais relevantes no seu setor, não apenas os frontier models horizontais. Quem está construindo o Harvey do seu mercado? O BloombergGPT do seu nicho? Se existe, você precisa entender se é parceiro, se é ameaça ou se há espaço para sua organização construir algo próprio antes que alguém chegue primeiro.
Nenhum desses três movimentos depende de tecnologia exótica. Dependem de olhar executivo atualizado e disposição para redesenhar prioridades.
Termino onde comecei. Com o nome do modelo.
Rosalind Franklin foi a cientista cuja fotografia 51 capturou a estrutura em dupla hélice do DNA em 1952. Sua contribuição foi central para a descoberta que mudou a biologia moderna. Mas o Nobel de 1962 foi para Watson, Crick e Wilkins. Rosalind havia morrido em 1958, e talvez mais importante, sua contribuição havia sido historicamente apagada do reconhecimento público. Décadas se passaram até que a comunidade científica começasse a restabelecer seu lugar na história.
Há uma ironia potente no fato de a OpenAI ter escolhido esse nome para o primeiro modelo verticalizado em ciências da vida. O nome homenageia alguém que só foi reconhecida por sua profundidade décadas depois do tempo em que ela foi entregue. E chega em um momento em que o mercado de IA começa, finalmente, a reconhecer que profundidade setorial vale mais que amplitude genérica.
A pergunta que sobra para cada líder executivo que leu este artigo é incômoda, mas honesta. Em que ponto da sua organização você ainda confunde amplitude com relevância? Em que área você ainda compra capacidade geral quando o que o problema pede é profundidade específica?
Porque o movimento já começou. Rosalind é só o anúncio de que ele ficou impossível de ignorar.
Você leu o post? Então faça login e tenha acesso ao recurso de “Marcar como lido”.